THE BRIEF HISTORY OF AI APPLICATIONS
3 июня 2025
Интро
Машинным обучением занимаются давно. Прогресс шел всегда в разных местах computer science. Искусственные нейронные сети известны, кажется, с 50-х и уже 30 лет назад были прикольные приложения, которые люди писали - например тут (https://www.youtube.com/watch?v=FwFduRA_L6Q) Ян ЛеКун (сейчас директор Мета), один из основоположников CCN архитектур в нейронных сетях, показывает как нейронка распознает цифры. Но больших прорывов в тех приложениях не было, скорее прикольные демки, которые в реальных задачах было тяжело применять.
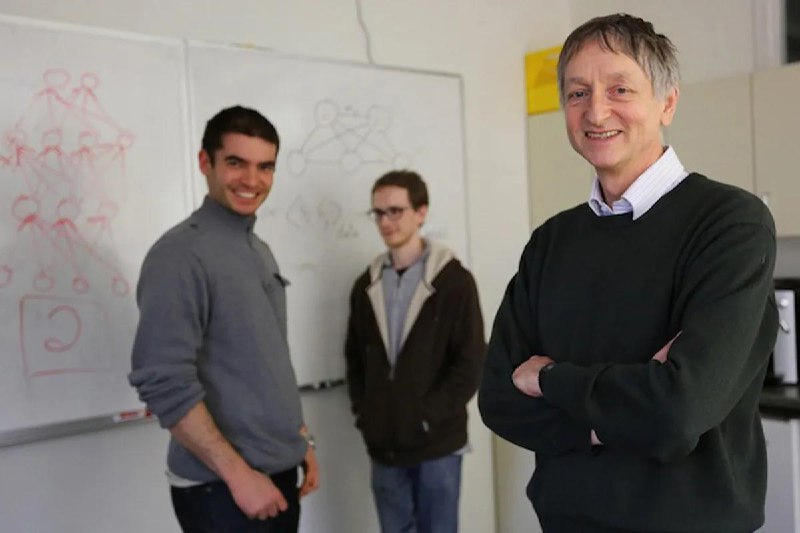
Все как-то развивалось более менее равномерно, пока в конце 2000-х Джеффри Хинтон (тот который нобелевку получил недавно, внезапно, по физике из-за своих работ в AI), который занимался долгое время психологией, работой мозга и впоследствии нейронными сетями, не понял что видеокарты (GPU) оказывается лучше подходят чем CPU для решения математических задач, которые нужно очень много решать в нейронных сетях (линейная алгебра, матричные операции, тензоры и тд). И тут случился прорыв. Конкретно в распознавании изображений.
Важно понимать контекст. К 2010 году у исследователей была одна большая проблема - не было нормального датасета для тренировки и тестирования моделей распознавания изображений. Были всякие мелкие наборы типа MNIST (рукописные цифры) или CIFAR-10 (32x32 картинки в 10 категориях), но это было как учиться водить машину на игрушечной трассе.
В те же годы Фей-Фей Ли из Стэнфорда сделала фундаментальную вещь - ImageNet. Она с командой собрала датасет из 14 миллионов картинок в 22 тысячах категорий. Но самое крутое - они запустили соревнование ImageNet Large Scale Visual Recognition Challenge (ILSVRC) в 2010 году. Задача простая: вот тебе миллион картинок для тренировки в 1000 категориях, покажи насколько хорошо твоя модель может их классифицировать.
Первые пару лет все решения были основаны на классическом компьютер вижене - выделяли features руками, потом скармливали в SVM или что-то подобное. Ошибка была около 25-30%. И тут в 2012 году пришли Хинтон с командой со своей моделью и просто уничтожили всех - ошибка 15.3%! Это был разрыв почти в 10 процентных пунктов с ближайшим конкурентом. Это много.
AlexNet
Хинтону и команде благодаря улучшению возможностей компьюта и новым подходам к архитектуре удалось натренировать очень крутую (по тем временам) нейронку - AlexNet (https://en.wikipedia.org/wiki/AlexNet). Один из учеников Хинтона, к слову, Илья Суцкевер, который впоследствии будет одним из сооснователей OpenAI.
От AlexNet, в 2012 году, можно сказать пошел отсчет глубоких нейронных сетей - когда народ понял, что архитектуры, которые еще 30 лет назад описывали на самом деле работают, просто их надо было делать гораздо больше (больше нейронов) и тратить больше вычислительных мощностей, чтобы сеть обучалась.
Потом был опять планомерный прогресс по всем дисциплинам внутри машин лернинга в течение следующих 5 лет - хорошее распознавание изображений, распознавание и синтез речи, перенос стилей изображений и тд. Появились очень хайповые приложения - такие как Prisma или MSQRD. Был основан OpenAI, где-то на стыке 2015/2016 годов.
Но при всем при этом принципиального прорыва не случалось, как так нейронки тогда (по сегодняшним временам довольно маленькие), требовали много GPU для тренинга и инференса (так называют уже фактическую работу натренированной нейронки).
Все как бы хотели еще больше нейронки, понимали что чем больше, тем будут лучше результаты, но больше не было возможности особо.
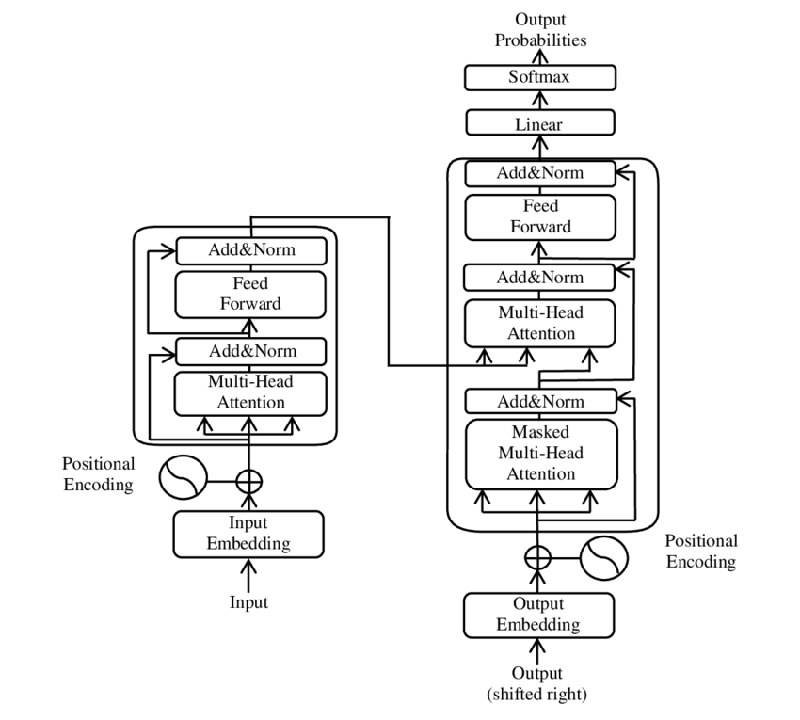
Так было пока в 2017 году ребята из Гугла не написали, теперь уже историческую работу - Attention is all you need (https://en.wikipedia.org/wiki/Attention_Is_All_You_Need). Где они представили сразу несколько прорывных идей по архитектурам нейронных сетей, а именно архитектуру которую сейчас называют Transformer. Одной из главных идей было “внимание” которое позволяло сетке лучше понимать контекст, а другой как технически можно лучше работать на уровне операций на GPU.
Это была прорывная работа. Тем не менее, несмотря на то, что эта работа была написана в Гугле, основным бенефициаром в скором времени оказались OpenAI. А человеком, который помог им в этом преуспеть - Илья Суцкевер. Слушал его интервью где он говорит, что когда увидел пейпер по трансформерам сразу понял, что это то что позволит им заскейлить их нейронки в OpenAI.
Эра трансформеров
После появления трансформеров началась настоящая гонка. В 2018 году Гугл выкатил BERT (Bidirectional Encoder Representations from Transformers) - модель, которая научилась понимать контекст слов с обеих сторон предложения. Это был прорыв для задач понимания языка - классификации, ответов на вопросы и т.д. BERT побил все рекорды на бенчмарках и показал, что предобучение на огромных корпусах текста дает невероятные результаты.
OpenAI работал долгое время над генерацией текста, а точнее над предсказанием какое слово будет следующим в наборе слов, которые подаются на импут в модель. Они применили там “трансформеры” и качество предсказаний существенно выросло, был прорыв. Так появились GPT-модели - Generative Pre-trained Transformer (https://en.wikipedia.org/wiki/Generative_pre-trained_transformer). OpenAI сначала GPT-модели предоставлял через API для разработчиков, а потом они сделали уже консьюмерский продукт ChatGPT.
В 2018 выпустили GPT-1. Это была относительно небольшая модель на порядка 100 миллионов параметров, но она уже показывала, что можно взять трансформер, натренировать его предсказывать следующее слово на куче текста из интернета, а потом дообучить на конкретные задачи.
В 2019 они выпустили GPT-2 с 1.5 миллиардами параметров. И тут случилось интересное - OpenAI сначала отказались публиковать полную модель, заявив что она слишком опасна, может генерировать фейк-ньюс и т.д. Народ посмеялся, но когда модель все-таки выложили, оказалось что она реально умеет генерировать очень убедительные тексты. Это был первый звоночек что мы приближаемся к чему-то серьезному.
Все так и вышло как предсказывал Суцкевер. Сейчас “трансформеры” по факту везде под капотом у ML-приложений, которые теперь уже называются AI-приложения. Почти все улучшения в генерации видео, картинок, текста и тд сегодня это применения архитектуры, которую опубликовали в 2017 году ребята из Гугла.
Более того. За последние 3-4 года почти все крупные вендоры железа стали проектировать GPU/TPU/AI-чипы именно под потребности трансформеров.
Революция ChatGPT
В 2020 году OpenAI выпустили GPT-3 с 175 миллиардами параметров - монстр по сравнению с предыдущими версиями. Но настоящая революция случилась когда OpenAI придумали как сделать эти модели полезными для обычных людей.
Дело в том, что если просто брать пре-трейн модель, такую какой например была GPT-3 и попробовать с ней говорить так, как ты привык сейчас с современными чат-ботами, но никакого долгого диалога не получится. Это будет скорее набор логичных, но не очень связанных текстов. Неплохо для, того чтобы получить короткий ответ, но точно не AI-собеседник. До прохождения теста Тьюринга еще далеко.
Секретным соусом стал RLHF - Reinforcement Learning from Human Feedback.
Идея RLHF простая: берем кучу людей, они оценивают какие ответы модели хорошие, а какие плохие. На основе этих оценок тренируем еще одну модель (reward model), которая учится предсказывать что людям понравится. А потом используем reinforcement learning чтобы основная модель генерировала ответы, которые понравятся этой reward model. По сути, учим AI быть helpful, harmless и honest через человеческую обратную связь.
Именно RLHF превратил сырую GPT-3.5 в ChatGPT, который в ноябре 2022 взорвал интернет. Это был самый быстрорастущий консьюмерский продукт в истории.
Этот прорыв, который получился в первую очередь у OpenAI году в 2021/2022, уже подстегнул всех остальных - стартапы, венчурных инвесторов, больших техно-гигантов, к инвестированию денег и времени в эту индустрию. В частности акции Nvidia выросли в 10 раз на бешеном спросе на свои чипы, так как они являются дефолтным выбором для всех кто хочет обучать и инференсить нейронки.
LLM
LLM - это Large Language Models, в целом название класса, но по факту сегодня часть трансформеров работающих с текстом.
Если говорить чисто о тексте, то можно разбить происходящее сегодня на два этапа:
- Сначала все улучшали качество за счет увеличения количества GPU и данных (например GPT-1/2/3/4/4o модели OpenAI)
- Потом все уперлись в некий потолок по компьюту/данным и начали делать активную пост-трейн оптимизацию, так называемый reasoning - если упрощать, то улучшение ответов за счет того, что сеть прогоняет сгенеренный ответ через себя опять и оценивает его качество. Потом отдает улучшенный ответ (например o1, o3, o3-mini модели OpenAI)
Сейчас у каждого провайдера LLM есть куча разных моделек, для разных целей - какие-то быстрее и дешевле, какие-то подороже и дольше думают, какие-то лучше для общих задач, какие-то лучше для кодинга и тд.
На рынке сейчас огромное количество разных LLM моделей - проприетарных и опенсорсных. Выбрать есть из чего. Перечислю лишь некоторые из тех что на слуху на весну-лето 2025:
OpenAI
- Много разных моделей, хорошее качество в среднем по многим задачам
- Есть ChatGPT - с огромным отрывом самый популярный консьюмерсий AI продукт, у них сотни миллионов пользователей
Anthropic
- Наверное можно официально назвать номер 2 после OpenAI по совокупности факторов
- Мой фаворит, мы их юзаем очень много
- Их модель Claude-Sonnet 3.5/3.7 отличная для почти всех задач, в частности для генерации кода и копирайтинга
- Апдейт сейчас уже появились модели 4
Gemini
- Гугловский продукт
- Последние модели очень хорошие
- Главная фишка огромное контекстное окно, то есть можно загружать много материалов в чат или просто очень долго есть вести без прерывания
- Гугл вообще должны быть лидерами в этом учитывая что почти всем занимаются, и те же трансформеры придумали и свои чипы делают (TPU, конкуренты nvidia), но пока отстают в гонке за разработчиками и консьюмерами. Но думаю имею шансы наверстать
Gemma
- Тоже гугл, но опенсорс
- Последние модели довольно неплохие по бенчмаркам
Meta
- Делают главную опенсорс модель в мире сейчас - LLama
- Неплохая базовая LLMка, используется много где как основа для файн-тюна и дообучения
Mistral
- Французская AI компания делающая одноименные модели, многие из которых выкладывает в опен-сорс
- Как Тоттенхэм, “Говном ты не был, но и до вершин не добрался”
Grok
- Продукт xAI
- Вроде неплохой API
- Их последняя модель натренирована на самом большой кластере на сегодняшний день
- При всем маркетинге от Маска они пока не набрали большой популярности за пределами Twitter/X
- Но время покажет - все-таки против Маска лучше не ставить
Deepseek
- Это те китайцы, которые взорвали рынок своей оперсорсной моделью по качеству почти не уступающей лучшей модели OpenAI, и потратили на это они сильно меньше денег (но и сделали это на годы позже, что важно)
- Заняли понятную нишу с дешевой и относительно хорошей моделью (их модель можно использовать на куче платформ как правило дешевле всего остального)
Qwen
- Целое семейство моделей на любой вкус и цвет от Алибабы
- Некоторые модели являются лидерами в мире open-weight опережая те же лламу и дипсик
Оригинал на русском в моём телеграме.